Estos días, trabajando en una herramienta para comprobar el estado HTTP de diferentes URLs, me encontré con algo que a primera vista parecía bastante sencillo de interpretar.
Algunas páginas devolvían un 403 Forbidden cuando intentaba acceder simulando determinados agentes relacionados con IA.
La conclusión inmediata parece evidente:
Si devuelve un 403, ChatGPT no puede acceder a esa página.
Pero no necesariamente.
De hecho, cuanto más he profundizado en este problema, más claro tengo que estamos simplificando demasiado algo que va a ser importante en cualquier auditoría SEO o GEO.
Porque una cosa es que una petición concreta reciba un 403 y otra bastante diferente es poder afirmar que ChatGPT, Claude, Perplexity o cualquiera de sus crawlers oficiales no puede acceder a esa URL.
Y esa diferencia importa.
Primero: ¿qué significa realmente un 403?
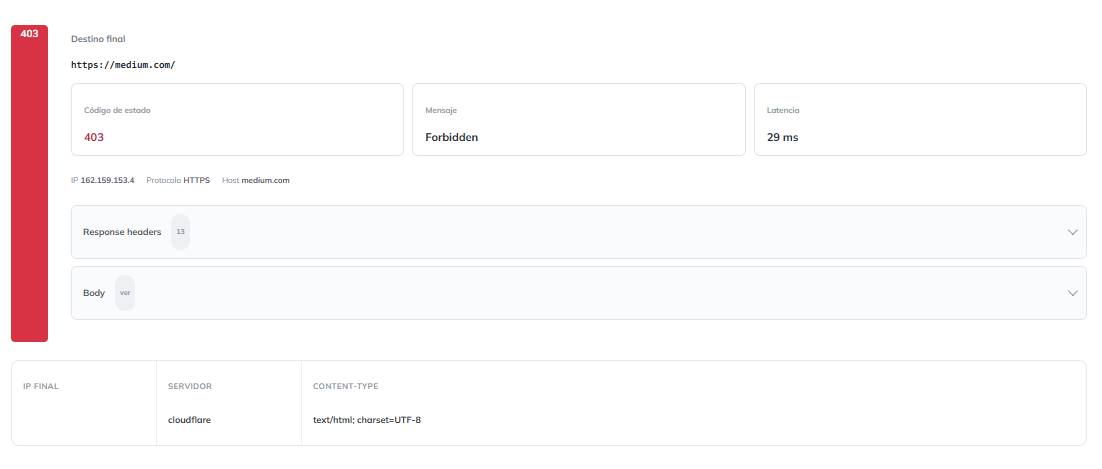
Sin entrar demasiado en HTTP, un código 403 Forbidden significa que el servidor ha recibido la petición, pero ha decidido no entregar el recurso solicitado.
Es decir, la URL existe y el servidor nos ha entendido.
Simplemente ha dicho:
“A ti no te dejo pasar”.
La parte importante está precisamente en ese a ti.
Porque el servidor no tiene por qué responder igual a todas las peticiones.
Puede devolver:
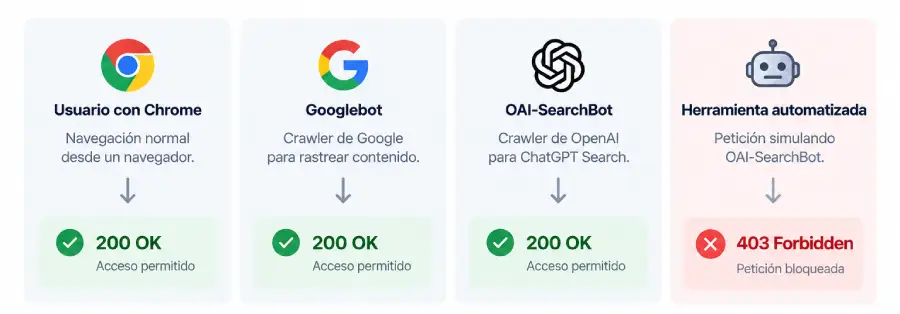
- 200 a una persona navegando con Chrome.
- 200 a Googlebot.
- 200 a OAI-SearchBot.
- 403 a un scraper.
- 403 a una herramienta SEO.
- 403 a una petición que intenta hacerse pasar por un crawler conocido.
La URL es exactamente la misma.
Lo que cambia es quién está haciendo la petición y cómo es identificado.
El error está en interpretar un 403 como “esta URL está bloqueada para la IA”
Creo que aquí tenemos uno de los primeros problemas que vamos a encontrarnos al auditar la accesibilidad de una web para agentes de IA.
Estamos intentando convertir un problema bastante complejo en un resultado binario:
Accesible / No accesible
Pero la realidad tiene bastantes más matices.
Cuando una herramienta consulta una URL y recibe un 403, lo único que sabemos con absoluta certeza es:
Esa petición concreta ha sido bloqueada.
No sabemos todavía si el crawler oficial recibiría la misma respuesta.
Y esto no es un matiz menor.
Un firewall, una CDN o un sistema antibot puede estar tomando decisiones a partir de diferentes señales: IP, User-Agent, reputación de la petición, comportamiento, frecuencia de solicitudes o reglas configuradas específicamente para determinados bots.
Por tanto:
Un 403 es una evidencia de bloqueo de una petición, no necesariamente una evidencia de bloqueo del crawler oficial.
Creo que esta distinción debería empezar a formar parte de cualquier análisis técnico relacionado con GEO.
Porque tampoco existe un único “bot de ChatGPT”
Otra simplificación habitual es hablar de “el crawler de ChatGPT” como si existiera un único agente recorriendo internet.
Actualmente OpenAI diferencia, entre otros, tres agentes con finalidades diferentes:
| Agente | Función principal |
|---|---|
| OAI-SearchBot | Descubrir contenido que puede aparecer en los resultados de búsqueda de ChatGPT |
| GPTBot | Rastrear contenido que puede utilizarse para mejorar y entrenar modelos |
| ChatGPT-User | Acceder a páginas como consecuencia de determinadas acciones realizadas por un usuario |
Y las tres cosas son independientes.
Una web puede permitir OAI-SearchBot para tener presencia en ChatGPT Search y bloquear GPTBot porque no quiere que su contenido sea utilizado para entrenamiento.
Además, ChatGPT-User tiene un comportamiento diferente porque el acceso puede producirse a raíz de una acción iniciada por una persona.
Anthropic sigue una separación similar con ClaudeBot, Claude-SearchBot y Claude-User.
Por eso probablemente deberíamos dejar de preguntar:
“¿ChatGPT puede acceder a mi web?”
Y empezar a preguntar algo bastante más preciso:
“¿Qué agente puede acceder, para qué finalidad y bajo qué condiciones?”
El User-Agent tampoco demuestra quién está haciendo realmente la petición
Aquí aparece otro problema interesante.
Imaginemos que queremos comprobar si una página permite el acceso de OAI-SearchBot.
Podríamos realizar una petición utilizando su User-Agent oficial.
Aparentemente estaríamos simulando al crawler de OpenAI.
Pero escribir:
User-Agent: OAI-SearchBot
no convierte nuestra petición en OAI-SearchBot.
Es simplemente una cabecera HTTP.
Cualquiera puede utilizarla.
Precisamente por eso los sistemas modernos de protección antibot no tienen por qué fiarse únicamente del User-Agent.
Pueden utilizar otras señales para comprobar de dónde procede realmente la petición.
Esto introduce una limitación importante en cualquier herramienta de comprobación:
Simular el User-Agent de un crawler permite detectar determinados bloqueos, pero no permite afirmar de manera absoluta que el crawler oficial vaya a recibir exactamente la misma respuesta.
Y creo que esto hay que contarlo.
Porque de lo contrario podemos presentar como certeza algo que técnicamente solo es una señal.
Una misma URL puede responder de cuatro maneras diferentes
Creo que la forma más sencilla de entenderlo es imaginar varias peticiones contra exactamente la misma página.
¿La URL está bloqueada?
No exactamente.
Está bloqueando determinadas peticiones.
Y ahí es donde entran en juego elementos que tradicionalmente hemos analizado menos desde SEO: CDN, WAF, sistemas antibot, reglas de seguridad o incluso rate limiting.
Por tanto, dos peticiones aparentemente similares pueden terminar teniendo respuestas diferentes.
Robots.txt y un 403 tampoco significan lo mismo
Otro punto donde creo que existe bastante confusión.
robots.txt y los códigos HTTP actúan en capas diferentes.
El archivo robots.txt indica a un crawler qué partes de una web tiene permiso para rastrear.
Pero permitir un crawler en robots.txt no garantiza que posteriormente pueda acceder a la página.
Podemos tener algo como:
y posteriormente:
¿Por qué?
Porque entre la petición del crawler y el contenido pueden existir otras capas que decidan bloquearla.
Por ejemplo:
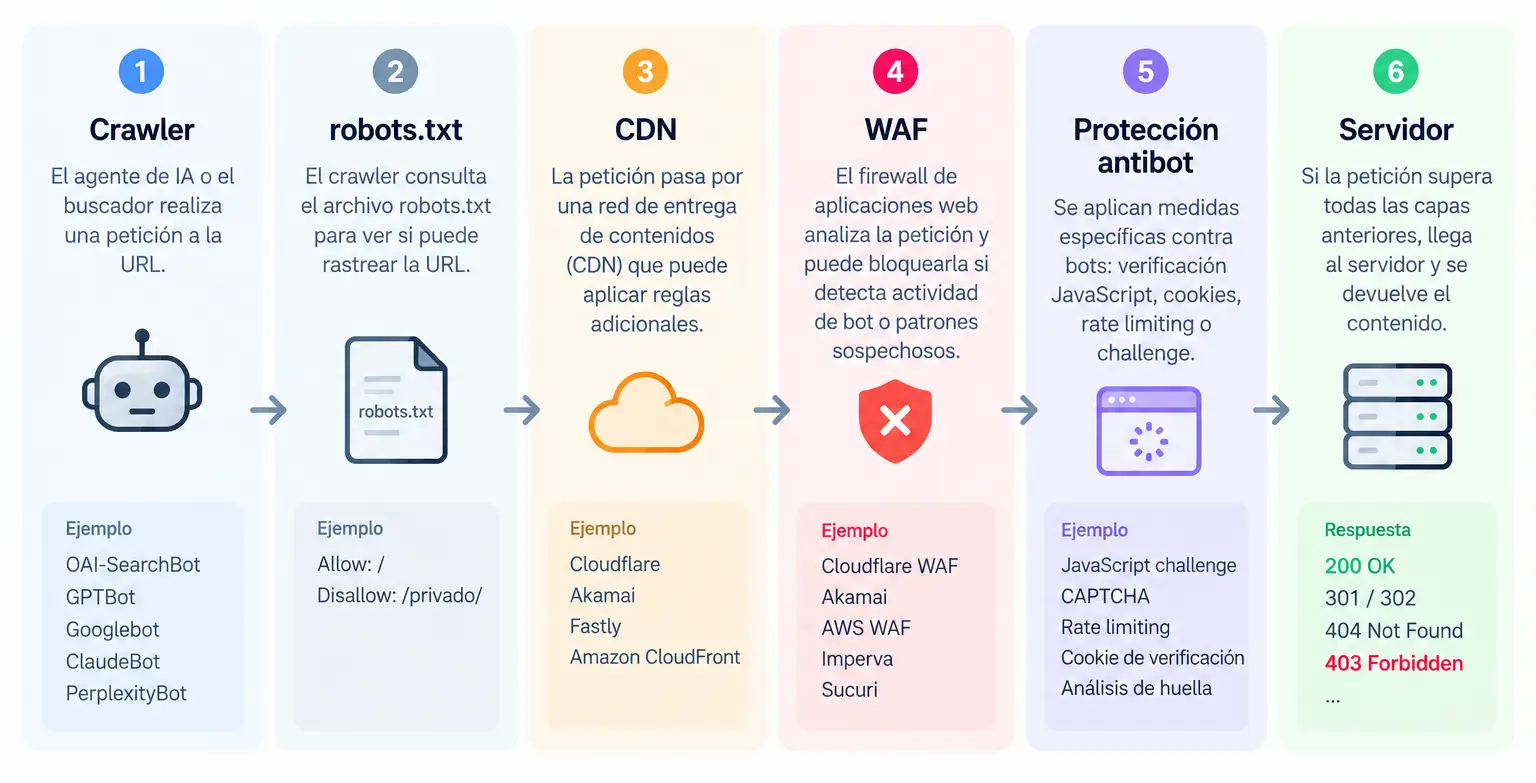
Permitir al crawler en la primera capa no garantiza que supere todas las siguientes.
Para mí, esta es una de las conclusiones más importantes de todo este análisis:
Comprobar el robots.txt ya no es suficiente para entender si una web es realmente accesible para los sistemas de IA.
Entonces, ¿cómo sabemos si una web está realmente bloqueando a un agente de IA?
Aquí es donde creo que tenemos que empezar a hablar más de niveles de evidencia que de respuestas absolutas.
Por ejemplo:
Si la URL devuelve 200
Sabemos que nuestra petición ha podido acceder al contenido.
Es una señal positiva.
Si devuelve 403
Sabemos que nuestra petición ha sido bloqueada.
Pero todavía necesitamos investigar por qué.
Puede tratarse de una regla específica contra ese agente, pero también de un WAF, un sistema antibot o una regla que bloquea tráfico automatizado en general.
Si robots.txt bloquea explícitamente al crawler
Tenemos una señal bastante más clara de intención.
La web está indicando que ese crawler no debe rastrear determinado contenido.
Si además el firewall o la CDN lo bloquea
La evidencia es mucho mayor.
No solo existe una directiva declarativa, sino también una barrera técnica impidiendo el acceso.
Por eso creo que una auditoría de accesibilidad para IA debería cruzar varias señales en lugar de quedarse únicamente con una.
La accesibilidad para IA no es binaria
Esta es probablemente la idea que más me interesa de todo esto.
Durante años hemos trabajado en SEO con estados relativamente conocidos:
- indexable;
- no indexable;
- rastreable;
- bloqueado;
- canonicalizado;
- etc.
Con la búsqueda basada en IA aparecen nuevas combinaciones.
Una página puede estar:
- accesible para buscadores tradicionales;
- accesible para OAI-SearchBot;
- bloqueada para GPTBot;
- accesible cuando un usuario pide a ChatGPT consultar esa URL;
- permitida en robots.txt;
- pero bloqueada por un WAF para determinadas peticiones automatizadas.
Por eso creo que debemos empezar a pensar en la accesibilidad IA por capas.
No se trata únicamente de preguntar si una URL responde.
Hay que entender todo el recorrido:
Descubrimiento → rastreo → acceso → recuperación del contenido → uso
Y, sobre todo, identificar qué agente interviene en cada momento.
No me extrañaría que este nivel de granularidad se convierta en algo habitual en las auditorías técnicas durante los próximos años.
Qué estoy haciendo yo con esta información
Todo este análisis empezó por un problema bastante práctico.
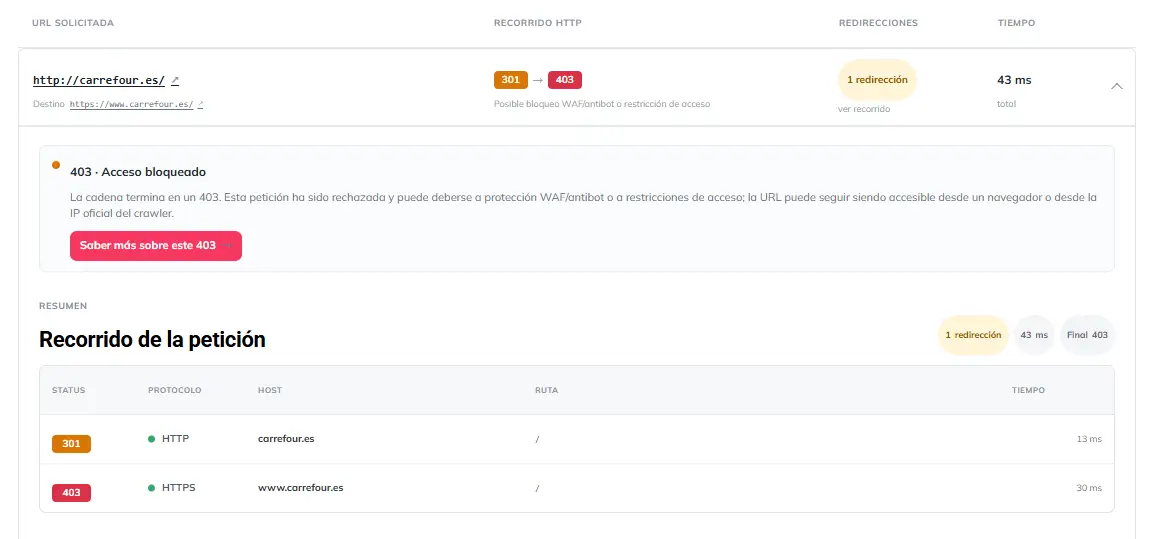
Mientras trabajaba en mi herramienta de comprobación HTTP, un 403 podía terminar interpretándose como:
“Este crawler está bloqueado”.
Y creo que esa afirmación es demasiado contundente.
La herramienta realmente sabe otra cosa:
“Esta petición ha recibido un 403”.
Por eso prefiero que el resultado explique algo parecido a:
403 · Petición bloqueada
El servidor ha rechazado esta solicitud. Puede deberse a un firewall, CDN o sistema antibot y no implica necesariamente que el crawler oficial esté bloqueado.
Puede parecer una diferencia pequeña de lenguaje.
Para mí no lo es.
Una herramienta de análisis debería intentar separar lo que sabemos de lo que estamos infiriendo.
Especialmente ahora que estamos entrando en un terreno como GEO donde todavía estamos construyendo buena parte de las metodologías.
De comprobar robots.txt a auditar realmente la accesibilidad para IA
Creo que durante los próximos meses vamos a ver muchas herramientas diciendo si una web “bloquea ChatGPT”, “permite Claude” o “es accesible para los LLM”.
Y probablemente tendremos que ser bastante cuidadosos con esas afirmaciones.
Porque saber si un agente aparece permitido en robots.txt es relativamente sencillo.
Saber si realmente puede acceder al contenido es otra cosa.
Y reproducir exactamente las condiciones bajo las que accede el crawler oficial puede ser todavía más complicado.
Por eso, al menos de momento, creo que la aproximación correcta no consiste en buscar un único check verde o rojo.
Consiste en reunir señales.
- Qué dice robots.txt.
- Qué respuesta HTTP obtenemos.
- Con qué User-Agent.
- Qué ocurre con una petición normal.
- Si existe un CDN o WAF.
- Si hay reglas antibot.
Y, cuando sea posible, qué muestran los logs del servidor sobre los crawlers oficiales.
Porque al final:
En GEO, comprobar la accesibilidad no consiste solo en mirar robots.txt. Hay que entender quién hace la petición, cómo se identifica y qué capa de la infraestructura decide si responde.
Y un 403, por sí solo, no siempre responde a todas esas preguntas.